¿Una tabla con poco volumen no necesita índices? Un caso real en SQL Server
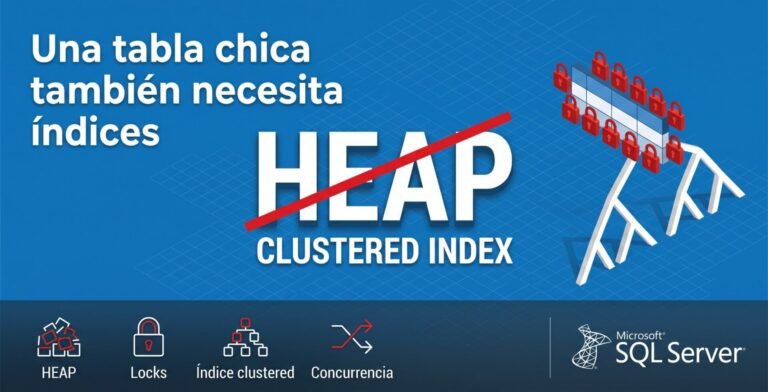
Por qué el volumen de registros no define por sí solo la estrategia de indexación
¿Considerás que no es necesario crear índices sobre una tabla simplemente porque tiene poco volumen de datos?
El caso que analizamos demuestra que el volumen de registros no es necesariamente un factor determinante a la hora de definir una estrategia de indexación.
En esta nota te contamos qué pasó, por qué sucede, cómo detectar este escenario en tus propias bases y cómo lo resolvimos.
🔍 El caso
Teníamos una tabla con un único registro, sin índices (HEAP) y sometida a cientos de operaciones DELETE + INSERT por segundo. A pesar de su tamaño insignificante, terminó generando una importante contención de locks, afectando la concurrencia de las operaciones.
SQL ServerBajo volumen: costo vs. beneficio del mantenimiento
- Tabla pequeña / pocas páginas
- Fragmentación porcentual alta
- Pocas páginas reales afectadas
- Beneficio potencial limitado
- Costo de rebuild:
log, CPU y bloqueo
Un porcentaje alto no implica automáticamente un problema: importa la cantidad de páginas y el patrón de acceso.
⚠️ ¿Por qué sucede esto?
En SQL Server, una tabla sin índice clustered se almacena como HEAP. Esto significa que no dispone de una estructura de organización basada en una clave de índice. Las operaciones de modificación deben localizar y gestionar los registros utilizando las estructuras internas del HEAP, como las páginas de datos y sus correspondientes identificadores físicos (RID).
Cuando existe una elevada frecuencia de modificaciones concurrentes, pueden producirse situaciones de competencia por los mismos recursos, bloqueos sobre páginas y escalamiento de la contención entre sesiones.
Además, las operaciones DELETE + INSERT no son operaciones neutras: implican modificaciones sobre las páginas de datos, administración de espacio, generación de registros en el transaction log y adquisición de locks durante la ejecución de las transacciones.
Un detalle de los HEAP que suele pasar desapercibido
En un HEAP, las páginas que quedan vacías después de un DELETE no siempre se liberan: salvo que la operación tome un bloqueo de tabla, el espacio puede quedar asignado. Con el tiempo, una tabla que contiene muy pocas filas puede ocupar más páginas de las que su contenido justifica, y cada búsqueda debe recorrerlas.
Por eso, en tablas con mucha rotación de registros, el tamaño lógico (cantidad de filas) y el tamaño físico (cantidad de páginas) pueden ser muy distintos.
🔎 ¿Cómo detectar este escenario en tus bases?
1. Identificar las tablas HEAP
Una tabla HEAP es aquella cuyo índice tiene index_id = 0. Esta consulta lista las tablas sin índice clustered de la base actual, junto con su cantidad de filas y de páginas:
SELECT s.name AS esquema,
       t.name AS tabla,
       SUM(p.rows) AS filas,
       SUM(a.total_pages) AS paginas
FROM sys.tables t
JOIN sys.schemas s ON s.schema_id = t.schema_id
JOIN sys.partitions p ON p.object_id = t.object_id AND p.index_id = 0
JOIN sys.allocation_units a ON a.container_id = p.partition_id
GROUP BY s.name, t.name
ORDER BY paginas DESC;
Si una tabla tiene muy pocas filas pero muchas páginas, es una señal de que conviene revisarla.
2. Medir cuánto se modifica cada tabla
La vista sys.dm_db_index_operational_stats muestra la actividad acumulada desde el último reinicio de la instancia, incluyendo inserciones, eliminaciones y esperas por bloqueos:
SELECT OBJECT_NAME(object_id) AS tabla,
       index_id,
       leaf_insert_count,
       leaf_delete_count,
       row_lock_wait_count,
       row_lock_wait_in_ms,
       page_lock_wait_count,
       page_lock_wait_in_ms
FROM sys.dm_db_index_operational_stats(DB_ID(), NULL, NULL, NULL)
WHERE index_id = 0
ORDER BY page_lock_wait_in_ms DESC;
Una tabla HEAP con muchas eliminaciones e inserciones y tiempos elevados de espera por bloqueos es candidata a recibir un índice clustered, sin importar cuántas filas tenga.
3. Ver los bloqueos en el momento en que ocurren
Cuando el problema está sucediendo, esta consulta muestra qué sesiones están bloqueadas, quién las bloquea y qué instrucción están ejecutando:
SELECT r.session_id,
       r.blocking_session_id,
       r.wait_type,
       r.wait_time,
       t.text AS instruccion
FROM sys.dm_exec_requests r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) t
WHERE r.blocking_session_id <> 0;
✅ Recomendación: guardar el resultado de estas consultas durante los momentos de mayor actividad. Permite demostrar con datos que la tabla es el origen de la contención antes de modificarla.
✅ La solución
En nuestro caso, la creación de un índice clustered permitió organizar físicamente los datos mediante una estructura B-Tree, proporcionando un mecanismo de acceso basado en la clave del índice. A partir de ese cambio, el problema de contención desapareció.
SQL ServerDecidir si conviene reconstruir un índice
- Medir tamaño y páginas
- ¿Hay scans relevantes?
- ¿Afecta el tiempo de respuesta?
No
- evitar acción innecesaria
Sí
- evaluar reorganize / rebuild
La decisión debe apoyarse en impacto medible, no exclusivamente en umbrales de fragmentación.
¿Por qué el índice clustered reduce la contención?
Con un índice clustered, SQL Server llega a la fila buscada recorriendo el árbol del índice a partir de su clave, en lugar de revisar las páginas del HEAP. Esto tiene dos efectos directos:
- Menos páginas leídas: cada operación accede solo a las páginas necesarias para encontrar la fila, aunque la tabla haya acumulado espacio sin liberar.
- Bloqueos más acotados: los bloqueos de fila se toman sobre la clave del índice, por lo que cada sesión retiene recursos más pequeños y durante menos tiempo, y disminuye la probabilidad de que las sesiones se esperen entre sí.
Además, las páginas que quedan vacías en un índice clustered se liberan y reutilizan de forma ordenada, evitando el crecimiento silencioso que puede ocurrir en un HEAP.
Un ejemplo ilustrativo, con nombres ficticios:
CREATE CLUSTERED INDEX CIX_Control_Id
ON dbo.Control (Id);
¿Cómo elegir la clave del índice clustered?
Como criterio general, una buena clave clustered es:
- Angosta: ocupa pocos bytes, porque se repite en todos los índices no clustered de la tabla.
- Única: si no lo es, SQL Server agrega internamente un valor para diferenciar las filas.
- Estable: no cambia con frecuencia, para evitar mover filas dentro del índice.
- Creciente: cuando es posible, valores que aumentan (como un identificador secuencial) reducen los page splits.
⚠️ Atención: la creación de un índice clustered reorganiza la tabla completa. En tablas pequeñas es una operación rápida, pero igual conviene ejecutarla en un horario controlado y validar antes el impacto en las consultas existentes.
📋 ¿Cuándo revisar una tabla aunque sea chica?
Más allá de la cantidad de filas, estas señales indican que una tabla merece atención:
- Recibe modificaciones con mucha frecuencia (cientos o miles por segundo).
- Es utilizada por muchas sesiones al mismo tiempo, como tablas de control, colas o contadores.
- Su patrón de uso es DELETE + INSERT sobre las mismas filas; en algunos casos puede evaluarse reemplazarlo por un UPDATE.
- Aparece con frecuencia en los bloqueos o en las esperas de la instancia.
- Tiene muchas más páginas de las que su cantidad de filas justificaría.
Conclusión
La conclusión es que la necesidad de indexación no debe evaluarse exclusivamente en función de la cantidad de registros de una tabla. También deben considerarse la frecuencia de modificación, la concurrencia, el patrón transaccional y la forma en que el motor accede a los datos.
Una tabla puede tener un solo registro y, aun así, convertirse en un cuello de botella si su diseño no contempla el volumen de operaciones concurrentes que debe soportar.
Si tenés problemas de bloqueos o contención en tu SQL Server, podés escribirnos a 📧 info@dba24.com.ar
📚 Te puede interesar: Particionamiento de tablas: ¿resuelve los problemas de performance?
- Autor
- Martin Jelenek
