MongoDB: Replicación y optimización de Replica Sets
Alta disponibilidad, parámetros de tuning y capacidad real de recuperación
Introducción
MongoDB dispone de un mecanismo nativo de replicación denominado Replica Set, que permite mantener múltiples copias de una base de datos en diferentes nodos, proporcionando alta disponibilidad y tolerancia a fallas.
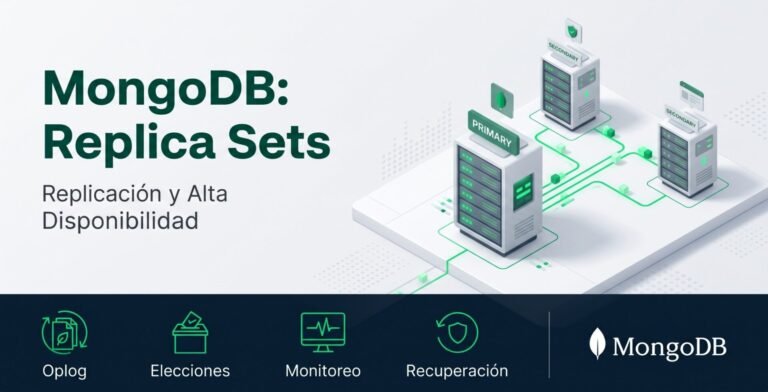
La arquitectura utiliza un nodo principal (Primary), responsable de las escrituras, y uno o más nodos secundarios (Secondary), que replican los cambios mediante un registro de operaciones denominado Oplog. Ante una falla del nodo principal, MongoDB realiza automáticamente una elección para designar un nuevo Primary.
En esta nota te contamos cuál es la arquitectura recomendada, qué parámetros revisar para optimizar la replicación, qué indicadores monitorear y cómo saber si tu réplica es realmente recuperable.
🧱 Solución recomendada
Para ambientes productivos se recomienda implementar un Replica Set de tres nodos con datos, preferentemente distribuidos en diferentes servidores o zonas de disponibilidad. Esto permite:
- Mantener redundancia de información.
- Automatizar la recuperación ante fallas.
- Distribuir operaciones de lectura entre nodos secundarios, cuando la aplicación lo permite.
- Reducir el riesgo de interrupciones del servicio.
MongoDBArquitectura de Replica Set
- Primary acepta escrituras
- Oplog registra operaciones
- Secondaries replican Oplog
- Elección ante falla del Primary
- Nuevo Primary si hay mayoría
El Replica Set automatiza la elección, pero el quorum y el estado de los miembros condicionan el failover.
⚙️ Parámetros principales de tuning
Los siguientes parámetros constituyen los principales puntos de revisión para optimizar la replicación. Los valores indicados son referencias iniciales y deben validarse según la versión de MongoDB, la topología y la carga de trabajo.
Parámetro | Referencia inicial | Objetivo |
| Según volumen de escrituras | Dimensionar la ventana de operaciones disponible para que un nodo retrasado pueda ponerse al día. |
| 10.000 ms | Determinar cuánto espera el Replica Set antes de considerar que el Primary dejó de responder. |
| 2.000 ms | Definir la frecuencia de comunicación y detección de estado entre los nodos. |
| Habilitado | Ayudar a controlar el ritmo de escrituras cuando los secundarios se retrasan. |
| majority | Solicitar confirmación de la mayoría de los miembros votantes para determinadas escrituras. |
| primary por defecto | Definir desde qué miembros se atienden las lecturas; usar secundarios solo cuando la aplicación tolere datos potencialmente atrasados. |
WiredTiger Cache | Según memoria y carga | Asignar memoria adecuada al motor de almacenamiento sin dejar al sistema operativo sin recursos. |
⚠️ Los ajustes deben realizarse en función del comportamiento real de la infraestructura y no modificarse indiscriminadamente. En particular, el tamaño del Oplog debe evaluarse por la cantidad de tiempo que cubre frente al volumen real de escrituras, y no solamente por su tamaño en megabytes.
MongoDBVentana Oplog y recuperación de un Secondary
- Secondary queda fuera de línea
- Oplog conserva operaciones
- ¿La ventana cubre el tiempo caído?
Sí
- catch-up incremental
No
- Initial Sync (reconstrucción)
El tamaño útil del Oplog se mide en tiempo de retención frente al volumen de escrituras, no solo en GB.
📐 ¿Cómo dimensionar y ajustar el Oplog?
El tamaño del Oplog debe expresarse en horas de operaciones retenidas, no solamente en megabytes. Ese valor es el que determina cuánto tiempo puede permanecer desconectado o atrasado un nodo secundario sin necesitar una sincronización completa.
Para estimarlo, se mide cuánto Oplog genera la base por hora en los períodos de mayor actividad y se lo multiplica por la ventana de recuperación deseada. Por ejemplo:
Dato | Valor |
Generación de Oplog en horario pico | 2 GB por hora |
Ventana de recuperación deseada | 48 horas |
Tamaño mínimo estimado | 96 GB |
Margen adicional (20%) | ≈ 115 GB |
Los valores son ilustrativos. La generación real depende del volumen de escrituras, del tamaño de los documentos y de las operaciones masivas que ejecute la aplicación.
Desde MongoDB 3.6 el tamaño del Oplog puede modificarse en caliente, nodo por nodo, mediante el comando replSetResizeOplog. El tamaño se indica en megabytes:
db.adminCommand({ replSetResizeOplog: 1, size: 117760 })A partir de MongoDB 4.4 también es posible definir un período mínimo de retención con la opción minRetentionHours, de forma que las entradas no se eliminen antes de ese tiempo aunque el Oplog alcance su tamaño configurado.
⚠️ Atención: el cambio debe aplicarse en cada miembro del Replica Set y validarse contra el espacio disponible en disco. Un Oplog más grande ocupa más almacenamiento.
🔍 ¿Cómo verificar el estado de la replicación?
MongoDB incluye comandos que permiten revisar rápidamente la salud del Replica Set desde mongosh:
rs.status(): muestra el estado de cada miembro (PRIMARY, SECONDARY, RECOVERING, etc.), su salud y la última operación aplicada.rs.printSecondaryReplicationInfo(): informa cuánto retraso tiene cada nodo secundario respecto del Primary.rs.printReplicationInfo(): muestra el tamaño configurado del Oplog y la ventana de tiempo que cubre actualmente (desde la primera hasta la última operación registrada).
Con estos tres comandos se puede responder lo esencial: qué nodo es el Primary, si los secundarios están al día y cuántas horas de operaciones conserva el Oplog.
✅ Recomendación: registrar periódicamente la ventana del Oplog y el retraso de los secundarios para construir una línea base y detectar a tiempo cualquier desvío.
📊 Monitoreo y mantenimiento
El mantenimiento de la replicación debe concentrarse en un conjunto reducido de indicadores que permitan anticipar problemas de sincronización y capacidad:
- Replication Lag: controlar el retraso de los nodos secundarios respecto del Primary.
- Oplog: verificar su tamaño y, especialmente, la ventana temporal de operaciones retenidas.
- CPU y memoria: identificar saturación de recursos que pueda impedir que un Secondary aplique los cambios a tiempo.
- Disco: controlar latencia y capacidad de procesamiento de operaciones de lectura y escritura.
- Disponibilidad: revisar cambios de Primary, elecciones y eventos de pérdida de comunicación entre nodos.
🔁 Un aspecto crítico: ¿Tenemos realmente una réplica recuperable?
Tener un Replica Set funcionando correctamente no garantiza necesariamente que podamos recuperar un nodo ante cualquier escenario de falla.
Si un nodo secundario permanece desconectado o demasiado retrasado, puede ocurrir que las operaciones que necesita ya no estén disponibles en el Oplog. En ese escenario, el nodo no podrá ponerse al día mediante la replicación incremental y podría necesitar una sincronización completa (Initial Sync).
Esto puede implicar:
- Transferencias de grandes volúmenes de información.
- Incremento del consumo de CPU, memoria y disco.
- Mayor tráfico de red.
- Posible impacto sobre el rendimiento general del entorno.
La pregunta que todo DBA debería hacerse es: si mañana perdemos un nodo durante 24 o 48 horas, ¿nuestro Replica Set tiene capacidad para recuperarlo sin reconstruirlo completamente?
La respuesta depende principalmente del dimensionamiento del Oplog, del volumen de escrituras y de la capacidad de procesamiento de los nodos secundarios. Por eso, no alcanza con verificar que todos los miembros estén activos: también es necesario comprobar que la arquitectura pueda recuperarse dentro de los tiempos esperados.
Conclusiones
MongoDB ofrece un mecanismo de replicación robusto y automatizado, pero requiere un dimensionamiento adecuado y monitoreo permanente para garantizar su correcto funcionamiento.
Desde el punto de vista del DBA, las prioridades deben ser mantener una ventana de Oplog suficiente, controlar el retraso de replicación y optimizar los recursos de almacenamiento y memoria.
La recomendación es establecer una línea base de rendimiento y realizar ajustes únicamente cuando las métricas evidencien problemas de capacidad, latencia o sincronización.
Si necesitás ayuda para revisar o dimensionar tu Replica Set de MongoDB, podés escribirnos a 📧 info@dba24.com.ar
📚 Te puede interesar: 10 KPIs clave en la gestión de bases de datos
- Autor
- Martin Jelenek
