PostgreSQL – Optimización de rendimiento en Streaming Replication sincrónica
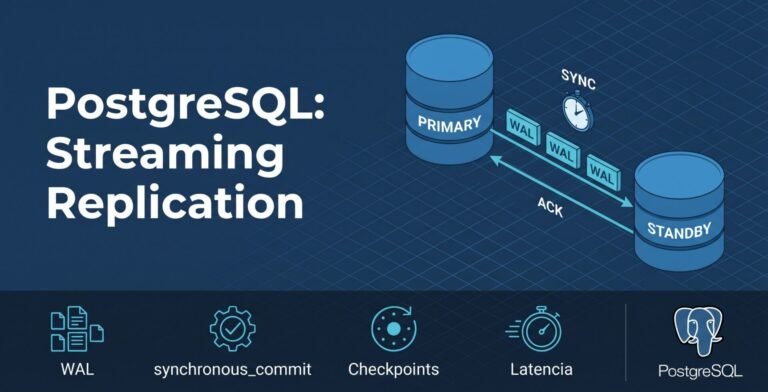
Cómo funciona la modalidad sincrónica y qué parámetros ajustar para reducir la latencia
Introducción
PostgreSQL dispone de un mecanismo nativo de replicación física denominado Streaming Replication, que permite mantener una instancia secundaria sincronizada con una instancia primaria mediante la transmisión continua de registros WAL (Write Ahead Log).
Cuando se configura en modalidad sincrónica, la instancia primaria espera la confirmación de la réplica antes de considerar completadas determinadas operaciones de escritura. Esto proporciona una mayor garantía de consistencia y protección ante fallas, pero introduce una dependencia directa de la latencia de red y del rendimiento de escritura de ambas instancias.
En ambientes con elevada actividad transaccional, esta espera puede impactar significativamente en los tiempos de respuesta y en la capacidad de procesamiento concurrente.
Por este motivo, resulta importante revisar determinados parámetros de PostgreSQL, tanto los relacionados directamente con la replicación como los que intervienen en la generación, escritura y persistencia del WAL.
En esta nota te contamos cómo funciona la replicación sincrónica, cuáles son los diez parámetros principales de rendimiento y qué revisar en la infraestructura.
🔁 Funcionamiento de la replicación sincrónica
En una configuración sincrónica, el flujo de una transacción es, simplificadamente, el siguiente:
- La aplicación ejecuta una transacción sobre la instancia primaria.
- PostgreSQL genera los registros correspondientes en el WAL.
- La instancia primaria transmite los registros a la réplica.
- La réplica recibe y persiste los registros WAL.
- La réplica envía la confirmación correspondiente.
- La instancia primaria completa el COMMIT y devuelve el resultado a la aplicación.
Por lo tanto, el tiempo de respuesta de una transacción puede quedar condicionado por el tiempo necesario para transmitir y persistir los registros en la instancia secundaria.
⚠️ Es importante considerar que una replicación sincrónica no implica necesariamente que la réplica ya haya aplicado todos los cambios a sus páginas de datos. Esto depende del nivel de confirmación configurado.
PostgreSQLStreaming replication con WAL
- Primary transacciones
- WAL generado
- WAL Sender por conexión
- Red / streaming
- WAL Receiver Standby
- Replay de WAL
La réplica recibe el flujo WAL y lo reproduce para mantener una copia consistente del primario.
⚙️ Parámetros principales de rendimiento
Los siguientes parámetros constituyen los principales puntos de revisión para ambientes con alta concurrencia y elevada generación de transacciones.
1. synchronous_commit
Objetivo: definir el nivel de confirmación requerido antes de completar un COMMIT. Es uno de los parámetros más importantes de la replicación sincrónica. Valores principales:
on: espera que la réplica confirme que el WAL recibido fue persistido en almacenamiento durable.remote_write: espera que la réplica haya escrito el WAL en su sistema operativo, sin exigir necesariamente su persistencia física mediante fsync.remote_apply: espera que la réplica haya aplicado los cambios recibidos y estos sean visibles para las consultas.local: espera únicamente la persistencia local del WAL.off: permite confirmar sin esperar la persistencia local del WAL, con el riesgo correspondiente ante una falla del servidor.
✅ Recomendación: utilizar on como referencia para mantener la garantía habitual de replicación sincrónica. Evaluar remote_write o remote_apply únicamente cuando exista una necesidad funcional concreta y se comprendan las diferencias de durabilidad y consistencia.
También es posible establecer este comportamiento por sesión o transacción, evitando modificar globalmente la garantía de durabilidad.
2. synchronous_standby_names
Objetivo: definir qué réplicas participan en la confirmación sincrónica.
Permite establecer qué instancia secundaria debe confirmar la recepción de los registros WAL para que la primaria complete sus transacciones.
En configuraciones con múltiples réplicas, también permite definir cuántas confirmaciones son necesarias mediante los modos FIRST y ANY.
✅ Recomendación: mantener una configuración acorde con la arquitectura de alta disponibilidad. Exigir confirmaciones de más réplicas de las necesarias incrementa la dependencia de red y almacenamiento y puede aumentar la latencia de los COMMIT.
3. wal_buffers
Objetivo: definir la memoria utilizada para almacenar temporalmente registros WAL antes de escribirlos.
En servidores con elevada actividad transaccional, un volumen importante de operaciones concurrentes puede generar presión sobre los buffers de WAL.
✅ Recomendación: revisar este parámetro cuando exista una alta tasa de generación de WAL. El valor automático (-1) suele ser adecuado, pero en determinadas cargas puede resultar conveniente evaluar valores de varios MB o superiores mediante pruebas controladas.
4. wal_writer_delay
Objetivo: controlar la frecuencia con la que el proceso WAL Writer realiza escrituras periódicas.
Su comportamiento influye principalmente en la escritura de WAL asociada a operaciones que no requieren una confirmación sincrónica inmediata.
✅ Recomendación: conservar inicialmente el valor predeterminado y evaluar modificaciones solamente cuando el patrón de escritura de WAL lo justifique. No debe considerarse un mecanismo directo para reducir la espera de los COMMIT sincrónicos.
5. wal_writer_flush_after
Objetivo: determinar el volumen de WAL generado antes de que el WAL Writer solicite una sincronización de escritura.
Permite controlar la frecuencia de las operaciones de flush realizadas por este proceso.
✅ Recomendación: revisar en conjunto con wal_writer_delay, especialmente en ambientes con generación sostenida de WAL. Su modificación debe validarse mediante pruebas de carga, ya que no reemplaza la persistencia exigida por la replicación sincrónica.
6. commit_delay
Objetivo: introducir una pequeña demora antes de iniciar la escritura del WAL, permitiendo agrupar confirmaciones concurrentes en una misma operación de flush (Group Commit).
En escenarios con numerosos clientes ejecutando transacciones simultáneamente, puede mejorar el throughput al reducir la cantidad de operaciones individuales de persistencia.
✅ Recomendación: evaluar valores pequeños únicamente cuando exista suficiente concurrencia. Una configuración inadecuada puede incrementar la latencia individual de las transacciones.
7. commit_siblings
Objetivo: establecer la cantidad mínima de transacciones concurrentes necesaria para que se aplique commit_delay.
Este parámetro trabaja conjuntamente con commit_delay y evita introducir demoras cuando no existe suficiente concurrencia para aprovechar el agrupamiento de confirmaciones.
✅ Recomendación: ajustar en conjunto con commit_delay, teniendo en cuenta la cantidad real de transacciones concurrentes del ambiente.
8. max_wal_size
Objetivo: establecer el tamaño máximo aproximado de WAL que puede acumularse antes de provocar un checkpoint anticipado.
En ambientes transaccionales, una generación elevada de WAL puede provocar checkpoints frecuentes, incrementando la actividad de escritura sobre el almacenamiento.
✅ Recomendación: evaluar un incremento cuando los checkpoints se producen con demasiada frecuencia por volumen de WAL. El valor debe dimensionarse según la generación de registros y la capacidad de almacenamiento disponible.
9. checkpoint_timeout
Objetivo: establecer el intervalo máximo entre checkpoints automáticos.
Un intervalo demasiado corto puede generar operaciones de checkpoint frecuentes y picos de I/O.
✅ Recomendación: evaluar intervalos mayores en ambientes de escritura intensiva, considerando que esto puede incrementar el tiempo de recuperación ante una caída inesperada.
10. checkpoint_completion_target
Objetivo: distribuir las operaciones de escritura de un checkpoint a lo largo del intervalo disponible.
Permite evitar concentrar una gran cantidad de operaciones de I/O en períodos cortos.
✅ Recomendación: mantener como referencia el valor 0.9, que permite distribuir las escrituras durante la mayor parte del intervalo entre checkpoints. Reducirlo generalmente concentra más la actividad de escritura y no suele ser conveniente para ambientes transaccionales.
PostgreSQLReplication slots y retención de WAL
- Standby se retrasa o desconecta
- Slot retiene WAL no confirmado
- WAL se acumula en Primary
- Riesgo de llenar disco
- Monitorear lag, slots y capacidad
Los slots evitan perder WAL requerido por una réplica, pero pueden retenerlo indefinidamente y agotar el almacenamiento.
🖥️ Consideraciones adicionales de infraestructura
La optimización de parámetros no reemplaza la necesidad de contar con una infraestructura adecuada. En una implementación sincrónica, deben considerarse especialmente:
- Latencia de red: la comunicación entre primaria y secundaria debe tener baja latencia y estabilidad.
- Almacenamiento: ambas instancias deben disponer de almacenamiento con buen rendimiento de escritura y persistencia.
- CPU y memoria: deben contar con recursos suficientes para procesar las operaciones y mantener la concurrencia.
- Ancho de banda: debe ser superior a la tasa de generación de WAL para evitar acumulación de retrasos.
- Distribución geográfica: evitar distancias físicas que introduzcan latencias incompatibles con los tiempos de respuesta esperados por las aplicaciones.
⚠️ Un punto fundamental es que la replicación sincrónica agrega una espera al COMMIT. Si la réplica tiene un almacenamiento lento o existe latencia de red elevada, incrementar buffers o modificar checkpoints no resolverá ese cuello de botella.
Conclusión
La Streaming Replication sincrónica constituye una solución robusta y nativa de PostgreSQL para implementar alta disponibilidad y mantener una réplica consistente de una base de datos.
Sin embargo, en ambientes con elevada actividad transaccional, su implementación debe acompañarse de una revisión específica del rendimiento.
Los principales aspectos a focalizar son el nivel de confirmación sincrónica, la configuración de las réplicas, la gestión de buffers y escrituras WAL, el aprovechamiento de Group Commit y la frecuencia de los checkpoints.
La optimización debe realizarse de manera controlada y mediante pruebas de carga representativas, priorizando la reducción de la latencia de confirmación sin comprometer las garantías de durabilidad y consistencia requeridas por el negocio.
Si necesitás ayuda para optimizar la replicación de tu PostgreSQL, podés escribirnos a 📧 info@dba24.com.ar
📚 Te puede interesar: Alta disponibilidad en PostgreSQL
- Autor
- Martin Jelenek
